|
|
|
|
@ -0,0 +1,230 @@
|
|
|
|
|
# Scikit-learn Kullanarak Regresyon Modeli Oluşturma: Verileri Hazırlama ve Görselleştirme
|
|
|
|
|
|
|
|
|
|

|
|
|
|
|
|
|
|
|
|
Bilgilendirme Görseli: [Dasani Madipalli](https://twitter.com/dasani_decoded)
|
|
|
|
|
|
|
|
|
|
## [Ders Öncesi Test](https://gray-sand-07a10f403.1.azurestaticapps.net/quiz/11?loc=tr)
|
|
|
|
|
|
|
|
|
|
> ### [Bu ders R dilinde de mevcuttur!](../solution/R/lesson_2-R.ipynb)
|
|
|
|
|
|
|
|
|
|
## Giriş
|
|
|
|
|
|
|
|
|
|
Scikit-learn ile makine öğrenimi modelinin oluşturulmasına başlamak için gerekli araçları kurduğunuza göre, artık verilerinize sorular sormaya başlayabilirsiniz. Verilerle çalışırken ve ML çözümleri uygularken, verinizin potansiyelini açığa çıkarmak için nasıl doğru sorular soracağınızı bilmeniz çok önemlidir.
|
|
|
|
|
|
|
|
|
|
Bu derste öğrenecekleriniz:
|
|
|
|
|
|
|
|
|
|
- Model oluşturmak için verilerinizi nasıl hazırlayacağınız.
|
|
|
|
|
- Veri görselleştirme için Matplotlib’i nasıl kullanacağınız.
|
|
|
|
|
|
|
|
|
|
[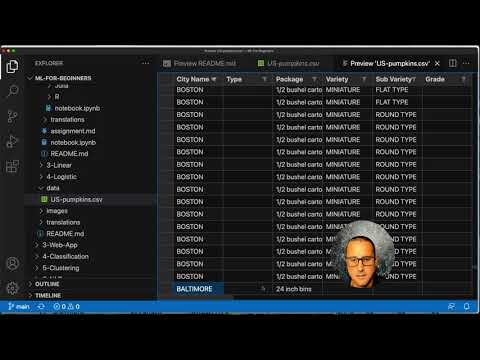](https://youtu.be/11AnOn_OAcE "Veri hazırlama ve görselleştirme videosu - İzlemek için tıklayın!")
|
|
|
|
|
> 🎥 Yukarıdaki görsele tıklayarak bu dersin önemli noktalarını içeren videoyu izleyebilirsiniz.
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
## Verilerinize Doğru Soruları Sormak
|
|
|
|
|
|
|
|
|
|
Cevabını aradığınız soru, hangi tür makine öğrenimi algoritmasına ihtiyaç duyacağınızı belirler. Alacağınız cevabın kalitesi ise büyük ölçüde verilerinizin doğasına bağlı olacaktır.
|
|
|
|
|
|
|
|
|
|
Bu derste yer alan [verilere](../../data/US-pumpkins.csv) göz atın. Bu `.csv` dosyasını VS Code veya başka bir düzenleyiciyle açabilirsiniz. Hızlı bir bakış, boş alanların ve sayı/metin karışık veri tiplerinin olduğunu hemen gösterir. Ayrıca "Package" adında, içerisinde 'sacks', 'bins' gibi değerlerin karışık halde bulunduğu bir sütun vardır. Veriler oldukça dağınık görünüyor.
|
|
|
|
|
|
|
|
|
|
Aslında, tamamen kullanıma hazır bir veri kümesi elde etmek çok yaygın değildir. Bu derste, standart Python kütüphanelerini kullanarak ham bir veri kümesinin nasıl hazırlanacağını öğreneceksiniz. Ayrıca çeşitli veri görselleştirme tekniklerini de inceleyeceksiniz.
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
## Çalışma Örneği: “Kabak Pazarı”
|
|
|
|
|
|
|
|
|
|
Bu dizinde, `data` klasörünün kökünde [US-pumpkins.csv](../../data/US-pumpkins.csv) adlı bir dosya bulacaksınız. Dosyada, şehir bazında sıralanmış 1757 satırlık bir kabak pazarı verisi yer alır. Bu veriler, ABD Tarım Bakanlığı (USDA) tarafından dağıtılan [Özel Ürün Terminal Pazar Standart Raporları](https://www.marketnews.usda.gov/mnp/fv-report-config-step1?type=termPrice) aracılığıyla elde edilmiştir.
|
|
|
|
|
|
|
|
|
|
### Verilerin Hazırlanması
|
|
|
|
|
|
|
|
|
|
Bu veriler kamu malıdır. USDA’nın web sitesinden, şehir bazında ayrı ayrı indirilebilir. Çok fazla dosyayla uğraşmamak için, tüm şehir verilerini tek bir sayfada birleştirip biraz hazırlık yaptık. Şimdi verileri daha yakından inceleyelim.
|
|
|
|
|
|
|
|
|
|
### Kabak Verileri - İlk Sonuçlar
|
|
|
|
|
|
|
|
|
|
Veriler hakkında neler fark ediyorsunuz? Daha önce de gördüğünüz gibi, içinde metin, sayılar, boş alanlar ve tuhaf değerler karışık halde bulunuyor.
|
|
|
|
|
|
|
|
|
|
Verilere, bir regresyon tekniği kullanarak hangi soruları sorabilirsiniz? Örneğin, “Belirli bir ayda kabak satış fiyatını tahmin edebilir miyiz?” diye düşünebilirsiniz. Verilere tekrar bakıldığında, bu soruya yönelik uygun veri yapılarını oluşturmak için birkaç değişiklik yapmanız gerektiği görülüyor.
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
## Alıştırma - Kabak Verilerini Analiz Etmek
|
|
|
|
|
|
|
|
|
|
[**Pandas**](https://pandas.pydata.org/) (ismini “Python Data Analysis” kısaltmasından alır) verilerin şekillendirilmesi için oldukça kullanışlı bir araçtır. Bu kabak verilerini analiz etmek ve hazırlamak için Pandas’ı kullanalım.
|
|
|
|
|
|
|
|
|
|
### 1. Önce, Eksik Tarihleri İnceleyin
|
|
|
|
|
|
|
|
|
|
Eksik tarihleri incelemek için birkaç adım atmanız gerekir:
|
|
|
|
|
|
|
|
|
|
1. Tarihleri ay formatına dönüştürün (ABD formatı `MM/DD/YYYY` olduğundan).
|
|
|
|
|
2. Yeni bir sütunda ay değerini tutun.
|
|
|
|
|
|
|
|
|
|
VS Code’da _notebook.ipynb_ dosyasını açın ve elektronik tabloyu Pandas’ta yeni bir DataFrame olarak içe aktarın.
|
|
|
|
|
|
|
|
|
|
1. İlk beş satırı görüntülemek için `head()` fonksiyonunu kullanın:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
import pandas as pd
|
|
|
|
|
pumpkins = pd.read_csv('../data/US-pumpkins.csv')
|
|
|
|
|
pumpkins.head()
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|
✅ Son beş satırı görüntülemek için hangi fonksiyonu kullanırdınız?
|
|
|
|
|
|
|
|
|
|
2. Veri çerçevenizde eksik veri olup olmadığını kontrol edin:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
pumpkins.isnull().sum()
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|
Eksik veriler mevcut, ancak bu belirli görev için belki o kadar önemli olmayabilir.
|
|
|
|
|
|
|
|
|
|
3. DataFrame’inizi daha yönetilebilir hale getirmek için bazı sütunları `drop()` ile atın ve yalnızca ihtiyacınız olan sütunları koruyun:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
new_columns = ['Package', 'Month', 'Low Price', 'High Price', 'Date']
|
|
|
|
|
pumpkins = pumpkins.drop([c for c in pumpkins.columns if c not in new_columns], axis=1)
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|
### 2. İkinci Adım, Kabakların Ortalama Fiyatını Belirleyin
|
|
|
|
|
|
|
|
|
|
Bir ay özelinde kabakların ortalama fiyatını nasıl belirleyebilirsiniz? İpucu: 3 sütuna ihtiyacınız var.
|
|
|
|
|
|
|
|
|
|
Çözüm: `Low Price` ve `High Price` sütunlarının ortalamasını alarak yeni `Price` sütununa kaydedin ve `Date` sütununu yalnızca ay değerini gösterecek şekilde dönüştürün. Yukarıdaki incelemeye göre, tarih veya fiyat sütunlarında eksik veri bulunmuyor.
|
|
|
|
|
|
|
|
|
|
1. Ortalamayı hesaplamak için aşağıdaki kodu ekleyin:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
price = (pumpkins['Low Price'] + pumpkins['High Price']) / 2
|
|
|
|
|
month = pd.DatetimeIndex(pumpkins['Date']).month
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|
✅ `print(month)` diyerek ay değerlerini görüntüleyip kontrol edebilirsiniz.
|
|
|
|
|
|
|
|
|
|
2. Dönüştürülen verilerinizi yeni bir Pandas DataFrame’e kopyalayın:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
new_pumpkins = pd.DataFrame({
|
|
|
|
|
'Month': month,
|
|
|
|
|
'Package': pumpkins['Package'],
|
|
|
|
|
'Low Price': pumpkins['Low Price'],
|
|
|
|
|
'High Price': pumpkins['High Price'],
|
|
|
|
|
'Price': price
|
|
|
|
|
})
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|
Bu DataFrame’i yazdırdığınızda, regresyon modelinizi oluşturmak için temiz ve düzenli bir veri kümesi elde ettiğinizi göreceksiniz.
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
### Ama Durun! Burada Bir Gariplik Var
|
|
|
|
|
|
|
|
|
|
`Package` sütununa bakarsanız, kabakların farklı şekillerde satıldığını görürsünüz. Bazıları “1 1/9 bushel” olarak, bazıları “1/2 bushel”, bazıları tane (parça) bazlı, bazıları pound (libre) bazında ve değişken genişlikli büyük kutularla satılıyor.
|
|
|
|
|
|
|
|
|
|
> Kabakların tutarlı bir şekilde tartılması oldukça zormuş gibi görünüyor.
|
|
|
|
|
|
|
|
|
|
Orijinal verilere baktığınızda, `Unit of Sale` değeri ‘EACH’ veya ‘PER BIN’ olanların `Package` değerlerinde inç, sepet veya ‘each’ gibi bilgiler de karışık halde. Kabaklar tutarlı bir şekilde tartılmıyor görünüyor. Bu nedenle, `Package` sütununda ‘bushel’ geçen kabakları filtreleyelim.
|
|
|
|
|
|
|
|
|
|
1. .csv’yi içe aktardığınız kodun hemen altına bir filtre ekleyin:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
pumpkins = pumpkins[pumpkins['Package'].str.contains('bushel', case=True, regex=True)]
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|
Verileri tekrar yazdırdığınızda, “bushel” (fanega) bazında satılan yaklaşık 415 satırlık verinin kaldığını görebilirsiniz.
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
### Ama Daha Bitmedi! Yapmanız Gereken Bir Şey Daha Var
|
|
|
|
|
|
|
|
|
|
Fark ettiğiniz gibi, “bushel” (fanega) miktarı satırdan satıra farklılık gösteriyor. Fanega başına fiyatı doğru şekilde göstermek için fiyatı normalleştirmeniz gerekiyor. Bunun için bazı hesaplamalar yapmalısınız.
|
|
|
|
|
|
|
|
|
|
1. `new_pumpkins` DataFrame’i oluşturduğunuz bloktan hemen sonra şu satırları ekleyin:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
new_pumpkins.loc[new_pumpkins['Package'].str.contains('1 1/9'), 'Price'] = price/(1 + 1/9)
|
|
|
|
|
new_pumpkins.loc[new_pumpkins['Package'].str.contains('1/2'), 'Price'] = price/(1/2)
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|
✅ [The Spruce Eats](https://www.thespruceeats.com/how-much-is-a-bushel-1389308) sitesine göre, bir faneganın ağırlığı ürüne göre değişir çünkü fanega bir hacim ölçüsüdür. “Örneğin, bir fanega domatesin 56 pound (libre) olması beklenir... Yapraklı yeşillikler daha fazla hacim kaplayıp daha az ağırlığa sahiptir, dolayısıyla bir fanega ıspanak sadece 20 pound’dur.” Tüm bunlar karmaşıktır! Fanegayı pound’a dönüştürmekle uğraşmak yerine fanega fiyatını baz alalım. Bu örnek, veri türünüzün doğasını anlamanın ne kadar önemli olduğunu gösteriyor!
|
|
|
|
|
|
|
|
|
|
Şimdi fiyatı fanegaya göre analiz edebilirsiniz. Verileri bir kez daha yazdırırsanız, normalleştirilmiş halde olduğunu görebilirsiniz.
|
|
|
|
|
|
|
|
|
|
✅ Yarım fanegalık kabakların neden daha pahalı göründüğünü fark ettiniz mi? Bunun sebebini bulabilir misiniz? İpucu: Küçük kabaklar daha pahalıdır çünkü aynı hacimdeki büyük bir kabağın bıraktığı boşluğu doldurmak için fanegaya daha fazla küçük kabak sığar.
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
## Görselleştirme Stratejileri
|
|
|
|
|
|
|
|
|
|
Bir veri bilimcisinin rolünün bir parçası, çalıştığı verilerin kalitesini ve doğasını gösterebilmektir. Bunu yapmak için genelde ilgi çekici görselleştirmeler, grafikler ve çizimler oluştururlar. Böylece, verilerdeki ilişkileri ve boşlukları, aksi halde keşfetmesi zor olabilecek şekilde görsel olarak gösterebilirler.
|
|
|
|
|
|
|
|
|
|
Görselleştirmeler ayrıca hangi makine öğrenimi tekniğinin veriler için daha uygun olduğunu belirlemeye yardımcı olur. Örneğin, düz bir çizgi etrafında kümelenen bir dağılım grafiği, doğrusal regresyona iyi bir aday olduğunu gösterebilir.
|
|
|
|
|
|
|
|
|
|
[Jupyter defterlerinde](https://jupyter.org/) (notebook) iyi çalışan bir veri görselleştirme kütüphanesi [**Matplotlib**](https://matplotlib.org/)’dir (daha önceki derste de kullanmıştınız).
|
|
|
|
|
|
|
|
|
|
> Veri görselleştirme konusunda daha fazla deneyim kazanmak için [bu eğitimlere](https://docs.microsoft.com/learn/modules/explore-analyze-data-with-python?WT.mc_id=academic-77952-leestott) göz atın.
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
## Alıştırma - Matplotlib ile Deney Yapın
|
|
|
|
|
|
|
|
|
|
Yeni oluşturduğunuz DataFrame’i göstermek için birkaç basit grafik oluşturmayı deneyin. Örneğin, basit bir çizgi grafiği ne gösterir?
|
|
|
|
|
|
|
|
|
|
1. Dosyanızın başına, Pandas’ın altına Matplotlib’i ekleyin:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
import matplotlib.pyplot as plt
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|
2. Tüm not defterini yeniden çalıştırarak güncelleyin.
|
|
|
|
|
3. Not defterinin sonuna bir hücre ekleyerek verileri bir kutu (ya da nokta) grafiği şeklinde gösterin:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
price = new_pumpkins.Price
|
|
|
|
|
month = new_pumpkins.Month
|
|
|
|
|
plt.scatter(price, month)
|
|
|
|
|
plt.show()
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|

|
|
|
|
|
|
|
|
|
|
Bu grafiğin faydası nedir? Sizi şaşırtan bir şey var mı?
|
|
|
|
|
|
|
|
|
|
Çok yararlı görünmeyebilir, çünkü sadece bir ay içindeki noktaları dağıtım şeklinde göstermektedir.
|
|
|
|
|
|
|
|
|
|
### Daha Faydalı Hale Getirmek
|
|
|
|
|
|
|
|
|
|
Daha faydalı görseller elde etmek için, verileri bir şekilde gruplamanız gerekir. Örneğin, dikey eksende ayları, yatay eksende ise fiyat dağılımını göstermek isteyebilirsiniz.
|
|
|
|
|
|
|
|
|
|
1. Gruplanmış bir sütun grafiği oluşturmak için şu hücreyi ekleyin:
|
|
|
|
|
|
|
|
|
|
```python
|
|
|
|
|
new_pumpkins.groupby(['Month'])['Price'].mean().plot(kind='bar')
|
|
|
|
|
plt.ylabel("Pumpkin Price")
|
|
|
|
|
```
|
|
|
|
|
|
|
|
|
|

|
|
|
|
|
|
|
|
|
|
Bu veri görselleştirmesi daha yararlı! Grafiğe göre, kabakların en yüksek fiyatı Eylül ve Ekim aylarında görünüyor. Bu sizin beklentinizle örtüşüyor mu? Neden?
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
## 🚀 Zorluk
|
|
|
|
|
|
|
|
|
|
Matplotlib’in sunduğu farklı görselleştirme türlerini keşfedin. Regresyon problemleri için hangi türler daha uygun olabilir?
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
## [Ders Sonrası Test](https://gray-sand-07a10f403.1.azurestaticapps.net/quiz/12?loc=es)
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
## İnceleme ve Öz Değerlendirme
|
|
|
|
|
|
|
|
|
|
Verileri görselleştirmenin farklı yollarına bakın. Mevcut kütüphanelerin listesini yapın ve hangi kütüphanenin hangi tür görevlere daha uygun olduğunu not edin. Örneğin, 2D ve 3D görselleştirme için hangileri uygundur? Neler keşfettiniz?
|
|
|
|
|
|
|
|
|
|
---
|
|
|
|
|
|
|
|
|
|
## Görev
|
|
|
|
|
|
|
|
|
|
[Veri Görselleştirmeyi Keşfetmek](assignment.tr.md)
|

 Talha Coşkun
2 years ago