
 leestott
9d4c123295 |
1 year ago | |
|---|---|---|
| .. | ||
| solution | 1 year ago | |
| README.md | 1 year ago | |
| assignment.ipynb | 1 year ago | |
| assignment.md | 1 year ago | |
| notebook.ipynb | 1 year ago | |
README.md
পরিসংখ্যান এবং সম্ভাবনার একটি সংক্ষিপ্ত পরিচিতি
 |
|---|
| পরিসংখ্যান এবং সম্ভাবনা - স্কেচনোট @nitya |
পরিসংখ্যান এবং সম্ভাবনা তত্ত্ব হলো গণিতের দুটি ঘনিষ্ঠভাবে সম্পর্কিত শাখা, যা ডেটা সায়েন্সের জন্য অত্যন্ত গুরুত্বপূর্ণ। গভীর গণিত জ্ঞান ছাড়াও ডেটার সাথে কাজ করা সম্ভব, তবে কিছু মৌলিক ধারণা জানা সবসময়ই ভালো। এখানে আমরা একটি সংক্ষিপ্ত পরিচিতি উপস্থাপন করব যা আপনাকে শুরু করতে সাহায্য করবে।
পূর্ব-লেকচার কুইজ
সম্ভাবনা এবং র্যান্ডম ভেরিয়েবল
সম্ভাবনা হলো ০ এবং ১ এর মধ্যে একটি সংখ্যা, যা একটি ঘটনার সম্ভাব্যতা প্রকাশ করে। এটি সংজ্ঞায়িত হয় ইতিবাচক ফলাফলের সংখ্যা (যা ঘটনাটি ঘটায়) এবং মোট ফলাফলের সংখ্যা দ্বারা ভাগ করে, ধরে নেওয়া হয় যে সব ফলাফল সমান সম্ভাব্য। উদাহরণস্বরূপ, একটি পাশা গড়ালে, জোড় সংখ্যার সম্ভাবনা হবে ৩/৬ = ০.৫।
ঘটনা নিয়ে কথা বলার সময় আমরা র্যান্ডম ভেরিয়েবল ব্যবহার করি। উদাহরণস্বরূপ, একটি পাশা গড়ানোর সময় প্রাপ্ত সংখ্যাকে উপস্থাপনকারী র্যান্ডম ভেরিয়েবলটি ১ থেকে ৬ পর্যন্ত মান নেবে। ১ থেকে ৬ পর্যন্ত সংখ্যার সেটটিকে নমুনা স্থান বলা হয়। আমরা একটি নির্দিষ্ট মান নেওয়ার সম্ভাবনা নিয়ে কথা বলতে পারি, যেমন P(X=3)=1/6।
উপরের উদাহরণে র্যান্ডম ভেরিয়েবলটিকে বিচ্ছিন্ন বলা হয়, কারণ এর নমুনা স্থান গণনাযোগ্য, অর্থাৎ পৃথক মান রয়েছে যা গণনা করা যায়। এমন কিছু ক্ষেত্রে নমুনা স্থান একটি বাস্তব সংখ্যার পরিসর বা পুরো বাস্তব সংখ্যার সেট হতে পারে। এমন ভেরিয়েবলগুলোকে অবিচ্ছিন্ন বলা হয়। একটি ভালো উদাহরণ হলো বাস আসার সময়।
সম্ভাবনা বণ্টন
বিচ্ছিন্ন র্যান্ডম ভেরিয়েবলের ক্ষেত্রে, প্রতিটি ঘটনার সম্ভাবনাকে একটি ফাংশন P(X) দ্বারা বর্ণনা করা সহজ। নমুনা স্থান S থেকে প্রতিটি মান s এর জন্য এটি ০ থেকে ১ এর মধ্যে একটি সংখ্যা দেবে, যাতে P(X=s) এর সব মানের যোগফল ১ হয়।
সবচেয়ে পরিচিত বিচ্ছিন্ন বণ্টন হলো সমবণ্টন, যেখানে N উপাদানের একটি নমুনা স্থান থাকে এবং প্রতিটির সম্ভাবনা ১/N হয়।
অবিচ্ছিন্ন ভেরিয়েবলের সম্ভাবনা বণ্টন বর্ণনা করা আরও কঠিন, যেখানে মানগুলো কিছু পরিসর [a,b] থেকে নেওয়া হয় বা পুরো বাস্তব সংখ্যার সেট ℝ থেকে। বাস আসার সময়ের ক্ষেত্রে চিন্তা করুন। প্রকৃতপক্ষে, নির্দিষ্ট একটি সময় t এ বাস আসার সম্ভাবনা ০!
এখন আপনি জানেন যে ০ সম্ভাবনার ঘটনা ঘটে, এবং তা প্রায়ই ঘটে! অন্তত প্রতিবার যখন বাস আসে!
আমরা কেবল একটি ভেরিয়েবলের নির্দিষ্ট মানের পরিসরে পড়ার সম্ভাবনা নিয়ে কথা বলতে পারি, যেমন P(t1≤X<t2)। এই ক্ষেত্রে, সম্ভাবনা বণ্টন একটি সম্ভাবনা ঘনত্ব ফাংশন p(x) দ্বারা বর্ণিত হয়, যাতে
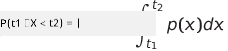
সমবণ্টনের অবিচ্ছিন্ন রূপকে অবিচ্ছিন্ন সমবণ্টন বলা হয়, যা একটি সসীম পরিসরে সংজ্ঞায়িত। একটি দৈর্ঘ্য l এর পরিসরে X মান পড়ার সম্ভাবনা l এর সমানুপাতিক এবং ১ পর্যন্ত বৃদ্ধি পায়।
আরেকটি গুরুত্বপূর্ণ বণ্টন হলো স্বাভাবিক বণ্টন, যা আমরা নিচে আরও বিস্তারিতভাবে আলোচনা করব।
গড়, বৈচিত্র্য এবং মান বিচ্যুতি
ধরা যাক আমরা একটি র্যান্ডম ভেরিয়েবল X এর nটি নমুনার একটি ক্রম আঁকি: x1, x2, ..., xn। আমরা ঐতিহ্যগতভাবে ক্রমটির গড় (বা গাণিতিক গড়) মানকে সংজ্ঞায়িত করতে পারি (x1+x2+xn)/n হিসাবে। যখন আমরা নমুনার আকার বাড়াই (অর্থাৎ n→∞ এর সীমা গ্রহণ করি), তখন আমরা বণ্টনের গড় (যাকে প্রত্যাশাও বলা হয়) পাই। আমরা প্রত্যাশাকে E(x) দ্বারা চিহ্নিত করব।
এটি প্রদর্শন করা যায় যে {x1, x2, ..., xN} মান এবং p1, p2, ..., pN সম্ভাবনা সহ যেকোনো বিচ্ছিন্ন বণ্টনের জন্য প্রত্যাশা হবে E(X)=x1p1+x2p2+...+xNpN।
মানগুলো কতটা ছড়িয়ে আছে তা নির্ধারণ করতে, আমরা বৈচিত্র্য σ2 = ∑(xi - μ)2/n গণনা করতে পারি, যেখানে μ হলো ক্রমটির গড়। σ কে মান বিচ্যুতি বলা হয় এবং σ2 কে বৈচিত্র্য বলা হয়।
মোড, মধ্যক এবং চতুর্থাংশ
কখনও কখনও গড় ডেটার "সাধারণ" মান যথাযথভাবে উপস্থাপন করে না। উদাহরণস্বরূপ, যখন কয়েকটি চরম মান থাকে যা সম্পূর্ণ পরিসরের বাইরে, তারা গড়কে প্রভাবিত করতে পারে। আরেকটি ভালো নির্দেশক হলো মধ্যক, একটি মান যাতে ডেটার অর্ধেক পয়েন্ট এর চেয়ে কম এবং বাকি অর্ধেক এর চেয়ে বেশি।
ডেটার বণ্টন বুঝতে সাহায্য করার জন্য চতুর্থাংশ নিয়ে কথা বলা সহায়ক:
- প্রথম চতুর্থাংশ, বা Q1, এমন একটি মান, যাতে ২৫% ডেটা এর নিচে পড়ে
- তৃতীয় চতুর্থাংশ, বা Q3, এমন একটি মান, যাতে ৭৫% ডেটা এর নিচে পড়ে
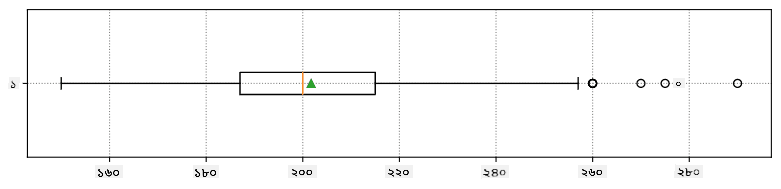
গ্রাফিক্যালি আমরা মধ্যক এবং চতুর্থাংশের সম্পর্ককে বক্স প্লট নামে একটি চিত্রে উপস্থাপন করতে পারি:

এখানে আমরা ইন্টার-চতুর্থাংশ পরিসর IQR=Q3-Q1 এবং তথাকথিত আউটলায়ার - মানগুলো, যা [Q1-1.5IQR,Q3+1.5IQR] সীমানার বাইরে পড়ে, গণনা করি।
যদি একটি সসীম বণ্টনে সম্ভাব্য মানের সংখ্যা কম থাকে, তবে একটি ভালো "সাধারণ" মান হলো সেটি যা সবচেয়ে বেশি বার ঘটে, যাকে মোড বলা হয়। এটি প্রায়ই শ্রেণীবদ্ধ ডেটার ক্ষেত্রে প্রয়োগ করা হয়, যেমন রং। ধরুন আমাদের কাছে দুটি গোষ্ঠী রয়েছে - কিছু লাল রং পছন্দ করে এবং অন্যরা নীল রং পছন্দ করে। যদি আমরা রংগুলোকে সংখ্যায় কোড করি, তবে প্রিয় রঙের গড় মান কমলা-সবুজ বর্ণালীতে কোথাও পড়বে, যা কোনো গোষ্ঠীর প্রকৃত পছন্দ নির্দেশ করে না। তবে মোড হয়তো একটি রং হবে, অথবা উভয় রং, যদি তাদের জন্য ভোট দেওয়া মানুষের সংখ্যা সমান হয় (এই ক্ষেত্রে আমরা নমুনাকে মাল্টিমোডাল বলি)।
বাস্তব জীবনের ডেটা
বাস্তব জীবনের ডেটা বিশ্লেষণ করার সময়, সেগুলো প্রায়শই র্যান্ডম ভেরিয়েবল নয়, এই অর্থে যে আমরা অজানা ফলাফলের সাথে পরীক্ষা করি না। উদাহরণস্বরূপ, একটি বেসবল দলের খেলোয়াড়দের উচ্চতা, ওজন এবং বয়সের মতো শারীরিক ডেটা বিবেচনা করুন। এই সংখ্যাগুলো পুরোপুরি র্যান্ডম নয়, তবে আমরা এখনও একই গাণিতিক ধারণা প্রয়োগ করতে পারি। উদাহরণস্বরূপ, মানুষের ওজনের একটি ক্রমকে কিছু র্যান্ডম ভেরিয়েবল থেকে নেওয়া মানের ক্রম হিসাবে বিবেচনা করা যেতে পারে। নিচে মেজর লীগ বেসবল থেকে খেলোয়াড়দের ওজনের একটি ক্রম দেওয়া হয়েছে, যা এই ডেটাসেট থেকে নেওয়া হয়েছে (আপনার সুবিধার জন্য, কেবল প্রথম ২০টি মান দেখানো হয়েছে):
[180.0, 215.0, 210.0, 210.0, 188.0, 176.0, 209.0, 200.0, 231.0, 180.0, 188.0, 180.0, 185.0, 160.0, 180.0, 185.0, 197.0, 189.0, 185.0, 219.0]
নোট: এই ডেটাসেট নিয়ে কাজ করার উদাহরণ দেখতে, সংযুক্ত নোটবুক দেখুন। এই পাঠে বেশ কিছু চ্যালেঞ্জ রয়েছে, এবং আপনি কিছু কোড যোগ করে সেগুলো সম্পন্ন করতে পারেন। যদি আপনি ডেটার উপর কাজ করতে না জানেন, চিন্তা করবেন না - আমরা পরে পাইথন ব্যবহার করে ডেটার সাথে কাজ করার বিষয়ে ফিরে আসব। যদি আপনি জুপিটার নোটবুকে কোড চালানোর পদ্ধতি না জানেন, এই নিবন্ধটি দেখুন।
এখানে আমাদের ডেটার গড়, মধ্যক এবং চতুর্থাংশ দেখানো একটি বক্স প্লট রয়েছে:
আমাদের ডেটায় বিভিন্ন খেলোয়াড়ের ভূমিকা সম্পর্কিত তথ্য রয়েছে, তাই আমরা ভূমিকা অনুযায়ী বক্স প্লটও করতে পারি - এটি আমাদের দেখাবে কীভাবে প্যারামিটার মানগুলো ভূমিকা অনুযায়ী ভিন্ন হয়। এবার আমরা উচ্চতা বিবেচনা করব:
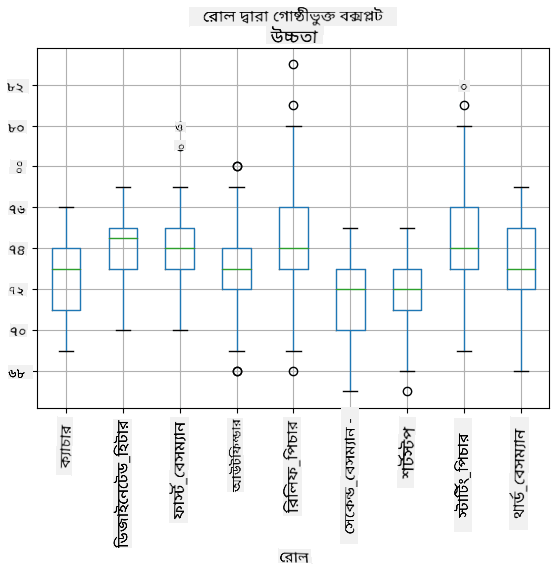
এই চিত্রটি নির্দেশ করে যে, গড়ে প্রথম বেসম্যানদের উচ্চতা দ্বিতীয় বেসম্যানদের উচ্চতার চেয়ে বেশি। এই পাঠে আমরা শিখব কীভাবে এই অনুমানটি আরও আনুষ্ঠানিকভাবে পরীক্ষা করা যায় এবং কীভাবে আমাদের ডেটা পরিসংখ্যানগতভাবে গুরুত্বপূর্ণ তা প্রদর্শন করা যায়।
বাস্তব জীবনের ডেটার সাথে কাজ করার সময়, আমরা ধরে নিই যে সমস্ত ডেটা পয়েন্ট কিছু সম্ভাবনা বণ্টন থেকে নেওয়া নমুনা। এই অনুমান আমাদের মেশিন লার্নিং কৌশল প্রয়োগ করতে এবং কার্যকর পূর্বাভাস মডেল তৈরি করতে সাহায্য করে।
আমাদের ডেটার বণ্টন দেখতে, আমরা হিস্টোগ্রাম নামে একটি গ্রাফ আঁকতে পারি। এক্স-অক্ষ বিভিন্ন ওজনের পরিসর (তথাকথিত বিন) ধারণ করবে, এবং উল্লম্ব অক্ষ দেখাবে আমাদের র্যান্ডম ভেরিয়েবল নমুনা একটি নির্দিষ্ট পরিসরে কতবার ছিল।
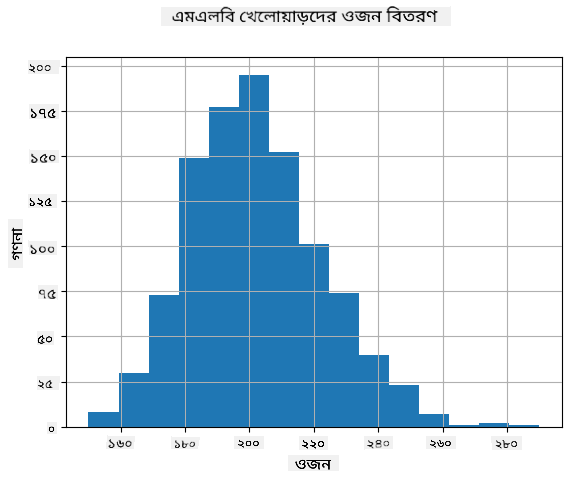
এই হিস্টোগ্রাম থেকে আপনি দেখতে পারেন যে সমস্ত মান একটি নির্দিষ্ট গড় ওজনের চারপাশে কেন্দ্রীভূত, এবং আমরা সেই ওজন থেকে যত দূরে যাই - তত কম ওজনের মান পাওয়া যায়। অর্থাৎ, একটি বেসবল খেলোয়াড়ের ওজন গড় ওজন থেকে খুব আলাদা হওয়া অত্যন্ত অসম্ভাব্য। ওজনের বৈচিত্র্য দেখায় যে ওজন গড় থেকে কতটা ভিন্ন হতে পারে।
যদি আমরা বেসবল লিগের বাইরের অন্য মানুষের ওজন নিই, তবে বণ্টনটি সম্ভবত ভিন্ন হবে। তবে বণ্টনের আকৃতি একই থাকবে, তবে গড় এবং বৈচিত্র্য পরিবর্তিত হবে। সুতরাং, যদি আমরা আমাদের মডেলটি বেসবল খেলোয়াড়দের উপর প্রশিক্ষণ দিই, এটি বিশ্ববিদ্যালয়ের ছাত্রদের উপর প্রয়োগ করলে ভুল ফলাফল দিতে পারে, কারণ অন্তর্নিহিত বণ্টনটি ভিন্ন।
স্বাভাবিক বণ্টন
উপরের ওজনের বণ্টনটি খুবই সাধারণ, এবং বাস্তব জীবনের অনেক পরিমাপ একই ধরনের বণ্টন অনুসরণ করে, তবে ভিন্ন গড় এবং বৈচিত্র্য সহ। এই বণ্টনটিকে স্বাভাবিক বণ্টন বলা হয়, এবং এটি পরিসংখ্যানে একটি অত্যন্ত গুরুত্বপূর্ণ ভূমিকা পালন করে।
স্বাভাবিক বণ্টন ব্যবহার করা সম্ভাব্য বেসবল খেলোয়াড়দের র্যান্ডম ওজন তৈরি করার একটি সঠিক উপায়। একবার আমরা গড় ওজন mean এবং মান বিচ্যুতি std জানলে, আমরা নিম্নলিখিতভাবে ১০০০টি ওজন নমুনা তৈরি করতে পারি:
samples = np.random.normal(mean,std,1000)
যদি আমরা তৈরি করা নমুনাগুলোর হিস্টোগ্রাম আঁকি, তবে আমরা উপরের ছবির মতো একটি চিত্র দেখতে পাব। এবং যদি আমরা নমুনার সংখ্যা এবং বিনের সংখ্যা বাড়াই, তবে আমরা একটি আদর্শ স্বাভাবিক বণ্টনের আরও কাছাকাছি একটি চিত্র তৈরি করতে পারি:
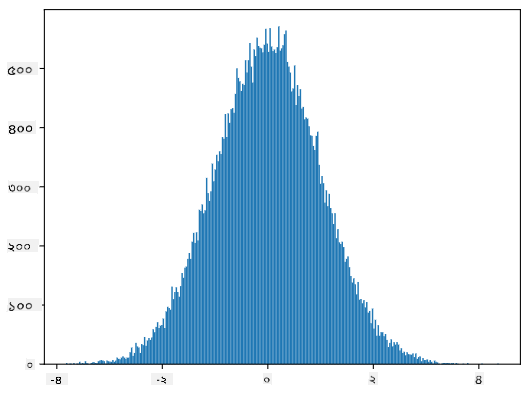
গড়=০ এবং মান বিচ্যুতি=১ সহ স্বাভাবিক বণ্টন
আত্মবিশ্বাসের পরিসর
যখন আমরা বেসবল খেলোয়াড়দের ওজন নিয়ে কথা বলি, আমরা ধরে নিই যে একটি নির্দিষ্ট র্যান্ডম ভেরিয়েবল W রয়েছে যা সমস্ত বেসবল খেলোয়াড়দের ওজনের আদর্শ সম্ভাবনা বণ্টনের সাথে মিলে যায় (তথাকথিত জনসংখ্যা)। আমাদের ওজনের ক্রমটি সমস্ত বেসবল খেলোয়াড়দের একটি উপসেটের সাথে মিলে যায়, যাকে আমরা নমুনা বলি। একটি আকর্ষণীয় প্রশ্ন হলো, আমরা কি W এর বণ্টনের প্যারামিটারগুলো, অর্থাৎ জনসংখ্যার গড় এবং বৈচিত্র্য জানতে পারি?
সবচেয়ে সহজ উত্তর হবে আমাদের নমুনার গড় এবং বৈচিত্র্য গণনা করা। তবে, এটি হতে পারে যে আমাদের র্যান্ডম নমুনা সম্পূর্ণ জনসংখ্যাকে সঠিকভাবে উপস্থাপন করে না। সুতরাং আত্মবিশ্বাসের পরিসর নিয়ে কথা বলা যৌক্তিক।
কনফিডেন্স ইন্টারভাল হলো জনসংখ্যার প্রকৃত গড় অনুমান করা, যা আমাদের নমুনার ভিত্তিতে নির্ধারণ করা হয় এবং এটি একটি নির্দিষ্ট সম্ভাবনা (বা কনফিডেন্স লেভেল) অনুযায়ী সঠিক। ধরি আমাদের ডিস্ট্রিবিউশন থেকে একটি নমুনা X1, ..., Xn আছে। প্রতিবার আমরা আমাদের ডিস্ট্রিবিউশন থেকে একটি নমুনা সংগ্রহ করি, আমরা ভিন্ন গড় মান μ পাব। সুতরাং μ-কে একটি র্যান্ডম ভেরিয়েবল হিসেবে বিবেচনা করা যেতে পারে। একটি কনফিডেন্স ইন্টারভাল যার কনফিডেন্স p, এটি একটি জোড়া মান (Lp,Rp), যাতে P(Lp≤μ≤Rp) = p, অর্থাৎ মাপা গড় মান এই ইন্টারভালের মধ্যে পড়ার সম্ভাবনা p এর সমান।
এই কনফিডেন্স ইন্টারভালগুলো কীভাবে গণনা করা হয় তা বিস্তারিতভাবে আলোচনা করা আমাদের সংক্ষিপ্ত পরিচয়ের বাইরে। আরও কিছু বিস্তারিত উইকিপিডিয়ায় পাওয়া যেতে পারে। সংক্ষেপে, আমরা প্রকৃত জনসংখ্যার গড়ের তুলনায় গণিতকৃত নমুনার গড়ের ডিস্ট্রিবিউশন সংজ্ঞায়িত করি, যাকে স্টুডেন্ট ডিস্ট্রিবিউশন বলা হয়।
মজার তথ্য: স্টুডেন্ট ডিস্ট্রিবিউশন নামকরণ করা হয়েছে গণিতবিদ উইলিয়াম সিলি গোসেট-এর নামে, যিনি "স্টুডেন্ট" ছদ্মনামে তার গবেষণা প্রকাশ করেছিলেন। তিনি গিনেস ব্রুয়ারিতে কাজ করতেন, এবং একটি মতানুযায়ী, তার নিয়োগকর্তা সাধারণ জনগণকে জানাতে চাননি যে তারা কাঁচামালের গুণমান নির্ধারণে পরিসংখ্যানগত পরীক্ষা ব্যবহার করছিলেন।
যদি আমরা আমাদের জনসংখ্যার গড় μ কনফিডেন্স p সহ অনুমান করতে চাই, তাহলে আমাদের স্টুডেন্ট ডিস্ট্রিবিউশন A এর (1-p)/2-থ পার্সেন্টাইল নিতে হবে, যা টেবিল থেকে নেওয়া যেতে পারে বা পরিসংখ্যান সফটওয়্যারের (যেমন Python, R ইত্যাদি) কিছু বিল্ট-ইন ফাংশন ব্যবহার করে গণনা করা যেতে পারে। এরপর μ এর জন্য ইন্টারভাল হবে X±A*D/√n, যেখানে X হলো নমুনার প্রাপ্ত গড়, D হলো স্ট্যান্ডার্ড ডেভিয়েশন।
নোট: আমরা ডিগ্রিস অফ ফ্রিডম এর একটি গুরুত্বপূর্ণ ধারণার আলোচনা এড়িয়ে যাচ্ছি, যা স্টুডেন্ট ডিস্ট্রিবিউশনের সাথে সম্পর্কিত। এই ধারণাটি আরও গভীরভাবে বুঝতে পরিসংখ্যানের সম্পূর্ণ বইগুলোতে রেফার করা যেতে পারে।
ওজন এবং উচ্চতার জন্য কনফিডেন্স ইন্টারভাল গণনার একটি উদাহরণ সংযুক্ত নোটবুকে দেওয়া হয়েছে।
| p | ওজনের গড় |
|---|---|
| 0.85 | 201.73±0.94 |
| 0.90 | 201.73±1.08 |
| 0.95 | 201.73±1.28 |
লক্ষ্য করুন যে কনফিডেন্স প্রোবাবিলিটি যত বেশি হয়, কনফিডেন্স ইন্টারভাল তত প্রশস্ত হয়।
হাইপোথিসিস টেস্টিং
আমাদের বেসবল খেলোয়াড়দের ডেটাসেটে বিভিন্ন খেলোয়াড়ের ভূমিকা রয়েছে, যা নিচে সংক্ষেপে দেওয়া হলো (এই টেবিল কীভাবে গণনা করা যায় তা দেখতে সংযুক্ত নোটবুক দেখুন):
| ভূমিকা | উচ্চতা | ওজন | সংখ্যা |
|---|---|---|---|
| ক্যাচার | 72.723684 | 204.328947 | 76 |
| ডিজাইনেটেড_হিটার | 74.222222 | 220.888889 | 18 |
| ফার্স্ট_বেসম্যান | 74.000000 | 213.109091 | 55 |
| আউটফিল্ডার | 73.010309 | 199.113402 | 194 |
| রিলিফ_পিচার | 74.374603 | 203.517460 | 315 |
| সেকেন্ড_বেসম্যান | 71.362069 | 184.344828 | 58 |
| শর্টস্টপ | 71.903846 | 182.923077 | 52 |
| স্টার্টিং_পিচার | 74.719457 | 205.163636 | 221 |
| থার্ড_বেসম্যান | 73.044444 | 200.955556 | 45 |
আমরা লক্ষ্য করতে পারি যে ফার্স্ট বেসম্যানদের গড় উচ্চতা সেকেন্ড বেসম্যানদের তুলনায় বেশি। সুতরাং, আমরা এই সিদ্ধান্তে পৌঁছাতে পারি যে ফার্স্ট বেসম্যানরা সেকেন্ড বেসম্যানদের তুলনায় লম্বা।
এই বিবৃতিকে একটি হাইপোথিসিস বলা হয়, কারণ আমরা জানি না এটি আসলে সত্য কিনা।
তবে, এটি সবসময় স্পষ্ট নয় যে আমরা এই সিদ্ধান্ত নিতে পারি। উপরের আলোচনায় আমরা জানি যে প্রতিটি গড়ের সাথে একটি কনফিডেন্স ইন্টারভাল যুক্ত থাকে, এবং এই পার্থক্যটি শুধুমাত্র একটি পরিসংখ্যানগত ত্রুটি হতে পারে। আমাদের হাইপোথিসিস পরীক্ষা করার জন্য আরও আনুষ্ঠানিক পদ্ধতির প্রয়োজন।
চলুন ফার্স্ট এবং সেকেন্ড বেসম্যানদের উচ্চতার জন্য আলাদাভাবে কনফিডেন্স ইন্টারভাল গণনা করি:
| কনফিডেন্স | ফার্স্ট বেসম্যান | সেকেন্ড বেসম্যান |
|---|---|---|
| 0.85 | 73.62..74.38 | 71.04..71.69 |
| 0.90 | 73.56..74.44 | 70.99..71.73 |
| 0.95 | 73.47..74.53 | 70.92..71.81 |
আমরা দেখতে পাই যে কোনো কনফিডেন্সেই ইন্টারভালগুলো ওভারল্যাপ করে না। এটি প্রমাণ করে যে ফার্স্ট বেসম্যানরা সেকেন্ড বেসম্যানদের তুলনায় লম্বা।
আরও আনুষ্ঠানিকভাবে, আমরা যে সমস্যাটি সমাধান করছি তা হলো দুটি প্রোবাবিলিটি ডিস্ট্রিবিউশন একই কিনা, অথবা অন্তত তাদের প্যারামিটারগুলো একই কিনা। ডিস্ট্রিবিউশন অনুযায়ী, আমাদের জন্য বিভিন্ন টেস্ট ব্যবহার করতে হবে। যদি আমরা জানি যে আমাদের ডিস্ট্রিবিউশনগুলো নরমাল, তাহলে আমরা স্টুডেন্ট টি-টেস্ট প্রয়োগ করতে পারি।
স্টুডেন্ট টি-টেস্টে, আমরা তথাকথিত টি-ভ্যালু গণনা করি, যা গড়ের পার্থক্যকে নির্দেশ করে, ভ্যারিয়েন্সকে বিবেচনায় নিয়ে। এটি প্রমাণিত হয়েছে যে টি-ভ্যালু স্টুডেন্ট ডিস্ট্রিবিউশন অনুসরণ করে, যা আমাদের একটি নির্দিষ্ট কনফিডেন্স লেভেল p এর জন্য থ্রেশহোল্ড মান পেতে সাহায্য করে (এটি গণনা করা যেতে পারে, অথবা সংখ্যাগত টেবিল থেকে দেখা যেতে পারে)। আমরা তারপর টি-ভ্যালুকে এই থ্রেশহোল্ডের সাথে তুলনা করি হাইপোথিসিস অনুমোদন বা প্রত্যাখ্যান করতে।
Python-এ, আমরা SciPy প্যাকেজ ব্যবহার করতে পারি, যা ttest_ind ফাংশন অন্তর্ভুক্ত করে (অন্যান্য অনেক দরকারী পরিসংখ্যানগত ফাংশন ছাড়াও!)। এটি আমাদের জন্য টি-ভ্যালু গণনা করে এবং কনফিডেন্স p-ভ্যালুর রিভার্স লুকআপও করে, যাতে আমরা কেবল কনফিডেন্স দেখে সিদ্ধান্ত নিতে পারি।
উদাহরণস্বরূপ, ফার্স্ট এবং সেকেন্ড বেসম্যানদের উচ্চতার তুলনা আমাদের নিম্নলিখিত ফলাফল দেয়:
from scipy.stats import ttest_ind

tval, pval = ttest_ind(df.loc[df['Role']=='First_Baseman',['Height']], df.loc[df['Role']=='Designated_Hitter',['Height']],equal_var=False)
print(f"T-value = {tval[0]:.2f}\nP-value: {pval[0]}")
T-value = 7.65
P-value: 9.137321189738925e-12
আমাদের ক্ষেত্রে, p-ভ্যালু খুবই কম, যা শক্তিশালী প্রমাণ দেয় যে ফার্স্ট বেসম্যানরা লম্বা।
এছাড়াও বিভিন্ন ধরনের হাইপোথিসিস রয়েছে যা আমরা পরীক্ষা করতে চাইতে পারি, যেমন:
- প্রমাণ করা যে একটি নির্দিষ্ট নমুনা কোনো ডিস্ট্রিবিউশন অনুসরণ করে। আমাদের ক্ষেত্রে আমরা ধরে নিয়েছি যে উচ্চতাগুলো নরমালি ডিস্ট্রিবিউটেড, কিন্তু এটি আনুষ্ঠানিক পরিসংখ্যানগত যাচাইয়ের প্রয়োজন।
- প্রমাণ করা যে একটি নমুনার গড় মান কোনো পূর্বনির্ধারিত মানের সাথে মিলে যায়।
- একাধিক নমুনার গড়ের তুলনা করা (যেমন: বিভিন্ন বয়স গ্রুপের মধ্যে সুখের স্তরের পার্থক্য কী)।
ল' অফ লার্জ নাম্বারস এবং সেন্ট্রাল লিমিট থিওরেম
নরমাল ডিস্ট্রিবিউশন এত গুরুত্বপূর্ণ হওয়ার একটি কারণ হলো সেন্ট্রাল লিমিট থিওরেম। ধরুন আমাদের কাছে একটি বড় নমুনা রয়েছে, যেখানে Nটি স্বাধীন মান X1, ..., XN, যেগুলো কোনো ডিস্ট্রিবিউশন থেকে গড় μ এবং ভ্যারিয়েন্স σ2 সহ সংগ্রহ করা হয়েছে। তাহলে, যথেষ্ট বড় N এর জন্য (অন্য কথায়, যখন N→∞), গড় ΣiXi নরমালি ডিস্ট্রিবিউটেড হবে, গড় μ এবং ভ্যারিয়েন্স σ2/N সহ।
সেন্ট্রাল লিমিট থিওরেমের আরেকটি ব্যাখ্যা হলো যে, ডিস্ট্রিবিউশন যাই হোক না কেন, যখন আপনি কোনো র্যান্ডম ভেরিয়েবল মানের যোগফলের গড় গণনা করেন, আপনি নরমাল ডিস্ট্রিবিউশন পাবেন।
সেন্ট্রাল লিমিট থিওরেম থেকে আরও বোঝা যায় যে, যখন N→∞, নমুনার গড় μ এর সমান হওয়ার সম্ভাবনা 1 হয়ে যায়। এটি ল' অফ লার্জ নাম্বারস নামে পরিচিত।
কোভেরিয়েন্স এবং করেলেশন
ডেটা সায়েন্সের একটি কাজ হলো ডেটার মধ্যে সম্পর্ক খুঁজে বের করা। আমরা বলি যে দুটি সিকোয়েন্স করেলেট করে যখন তারা একই সময়ে একই আচরণ প্রদর্শন করে, অর্থাৎ তারা একসাথে বৃদ্ধি/হ্রাস পায়, অথবা একটি সিকোয়েন্স বৃদ্ধি পেলে অন্যটি হ্রাস পায় এবং এর বিপরীত। অন্য কথায়, দুটি সিকোয়েন্সের মধ্যে কিছু সম্পর্ক রয়েছে বলে মনে হয়।
করেলেশন দুটি সিকোয়েন্সের মধ্যে কারণগত সম্পর্ক নির্দেশ করে না; কখনও কখনও উভয় ভেরিয়েবল কোনো বাহ্যিক কারণের উপর নির্ভর করতে পারে, অথবা এটি সম্পূর্ণভাবে কাকতালীয় হতে পারে যে দুটি সিকোয়েন্স করেলেট করে। তবে, শক্তিশালী গাণিতিক করেলেশন একটি ভালো ইঙ্গিত দেয় যে দুটি ভেরিয়েবল কোনোভাবে সংযুক্ত।
গাণিতিকভাবে, দুটি র্যান্ডম ভেরিয়েবলের মধ্যে সম্পর্ক দেখানোর প্রধান ধারণা হলো কোভেরিয়েন্স, যা এইভাবে গণনা করা হয়: Cov(X,Y) = E[(X-E(X))(Y-E(Y))]। আমরা উভয় ভেরিয়েবলের গড় মান থেকে বিচ্যুতি গণনা করি, এবং তারপর সেই বিচ্যুতির গুণফল। যদি উভয় ভেরিয়েবল একসাথে বিচ্যুত হয়, গুণফল সবসময় একটি ধনাত্মক মান হবে, যা ধনাত্মক কোভেরিয়েন্সে যোগ হবে। যদি উভয় ভেরিয়েবল অসামঞ্জস্যপূর্ণভাবে বিচ্যুত হয় (অর্থাৎ একটি গড়ের নিচে পড়ে যখন অন্যটি গড়ের উপরে উঠে), আমরা সবসময় ঋণাত্মক সংখ্যা পাব, যা ঋণাত্মক কোভেরিয়েন্সে যোগ হবে। যদি বিচ্যুতিগুলো নির্ভরশীল না হয়, তারা আনুমানিকভাবে শূন্যে যোগ হবে।
কোভেরিয়েন্সের পরম মান আমাদের করেলেশন কতটা বড় তা সম্পর্কে খুব বেশি কিছু বলে না, কারণ এটি প্রকৃত মানগুলোর মাত্রার উপর নির্ভর করে। এটি স্বাভাবিক করতে, আমরা উভয় ভেরিয়েবলের স্ট্যান্ডার্ড ডেভিয়েশন দ্বারা কোভেরিয়েন্সকে ভাগ করতে পারি, যাতে করেলেশন পাওয়া যায়। ভালো দিক হলো করেলেশন সবসময় [-1,1] এর মধ্যে থাকে, যেখানে 1 শক্তিশালী ধনাত্মক করেলেশন নির্দেশ করে, -1 শক্তিশালী ঋণাত্মক করেলেশন নির্দেশ করে, এবং 0 কোনো করেলেশন নির্দেশ করে না (ভেরিয়েবলগুলো স্বাধীন)।
উদাহরণ: আমরা বেসবল খেলোয়াড়দের ওজন এবং উচ্চতার মধ্যে করেলেশন গণনা করতে পারি উপরে উল্লেখিত ডেটাসেট থেকে:
print(np.corrcoef(weights,heights))
ফলস্বরূপ, আমরা করেলেশন ম্যাট্রিক্স পাই যা এই রকম:
array([[1.        , 0.52959196],
       [0.52959196, 1.        ]])
করেলেশন ম্যাট্রিক্স C যেকোনো সংখ্যক ইনপুট সিকোয়েন্স S1, ..., Sn এর জন্য গণনা করা যেতে পারে। Cij এর মান হলো Si এবং Sj এর মধ্যে করেলেশন, এবং ডায়াগোনাল উপাদানগুলো সবসময় 1 হয় (যা Si এর নিজস্ব করেলেশনও)।
আমাদের ক্ষেত্রে, মান 0.53 নির্দেশ করে যে একজন ব্যক্তির ওজন এবং উচ্চতার মধ্যে কিছু করেলেশন রয়েছে। আমরা একটি মানের বিপরীতে অন্য মানের স্ক্যাটার প্লটও তৈরি করতে পারি সম্পর্কটি দৃশ্যত দেখতে:
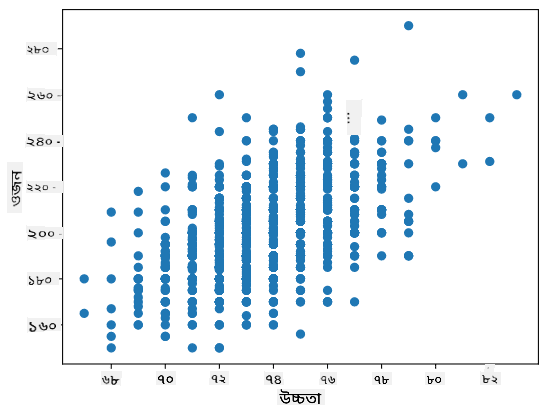
আরও করেলেশন এবং কোভেরিয়েন্সের উদাহরণ সংযুক্ত নোটবুকে পাওয়া যেতে পারে।
উপসংহার
এই অংশে, আমরা শিখেছি:
- ডেটার মৌলিক পরিসংখ্যানগত বৈশিষ্ট্য, যেমন গড়, ভ্যারিয়েন্স, মোড এবং কোয়ার্টাইল
- র্যান্ডম ভেরিয়েবলের বিভিন্ন ডিস্ট্রিবিউশন, যার মধ্যে নরমাল ডিস্ট্রিবিউশন অন্তর্ভুক্ত
- বিভিন্ন বৈশিষ্ট্যের মধ্যে করেলেশন কীভাবে খুঁজে বের করা যায়
- কিছু হাইপোথিসিস প্রমাণ করতে গণিত এবং পরিসংখ্যানের সঠিক পদ্ধতি কীভাবে ব্যবহার করা যায়
- ডেটা নমুনা থেকে র্যান্ডম ভেরিয়েবলের জন্য কনফিডেন্স ইন্টারভাল কীভাবে গণনা করা যায়
যদিও এটি সম্ভাবনা এবং পরিসংখ্যানের মধ্যে বিদ্যমান বিষয়গুলোর একটি সম্পূর্ণ তালিকা নয়, এটি এই কোর্সে একটি ভালো সূচনা দেওয়ার জন্য যথেষ্ট।
🚀 চ্যালেঞ্জ
নোটবুকে দেওয়া নমুনা কোড ব্যবহার করে অন্যান্য হাইপোথিসিস পরীক্ষা করুন:
- ফার্স্ট বেসম্যানরা সেকেন্ড বেসম্যানদের তুলনায় বেশি বয়সী
- ফার্স্ট বেসম্যানরা থার্ড বেসম্যানদের তুলনায় লম্বা
- শর্টস্টপরা সেকেন্ড বেসম্যানদের তুলনায় লম্বা
পোস্ট-লেকচার কুইজ
রিভিউ এবং স্ব-অধ্যয়ন
সম্ভাবনা এবং পরিসংখ্যান এত বিস্তৃত একটি বিষয় যে এটি নিজস্ব একটি কোর্সের যোগ্য। আপনি যদি তত্ত্বে আরও গভীরভাবে যেতে আগ্রহী হন, তাহলে আপনি নিম্নলিখিত বইগুলো পড়তে চাইতে পারেন:
- Carlos Fernandez-Granda নিউ ইয়র্ক ইউনিভার্সিটি থেকে Probability and Statistics for Data Science (অনলাইনে উপলব্ধ) নামে চমৎকার লেকচার নোট লিখেছেন।
- Peter and Andrew Bruce. Practical Statistics for Data Scientists. [R-এ নমুনা কোড]।
- James D. Miller. Statistics for Data Science [R-এ নমুনা কোড]।
অ্যাসাইনমেন্ট
ক্রেডিট
এই পাঠটি ♥️ দিয়ে Dmitry Soshnikov দ্বারা রচিত।
অস্বীকৃতি:
এই নথিটি AI অনুবাদ পরিষেবা Co-op Translator ব্যবহার করে অনুবাদ করা হয়েছে। আমরা যথাসম্ভব সঠিকতার জন্য চেষ্টা করি, তবে অনুগ্রহ করে মনে রাখবেন যে স্বয়ংক্রিয় অনুবাদে ত্রুটি বা অসঙ্গতি থাকতে পারে। মূল ভাষায় থাকা নথিটিকে প্রামাণিক উৎস হিসেবে বিবেচনা করা উচিত। গুরুত্বপূর্ণ তথ্যের জন্য, পেশাদার মানব অনুবাদ সুপারিশ করা হয়। এই অনুবাদ ব্যবহারের ফলে কোনো ভুল বোঝাবুঝি বা ভুল ব্যাখ্যা হলে আমরা দায়বদ্ধ থাকব না।